Texto del manual original para consulta. El PDF descargable conserva las capturas y la maquetación.
Página 1
NATURA X
VERSIÓN 1.2.0 / Limpieza vocal y selección de hablantes
Reduce ruido de fondo con DSP, RNNoise o un modo híbrido. Permite separar previamente una grabación de
dos hablantes y elegir cuál conservar.
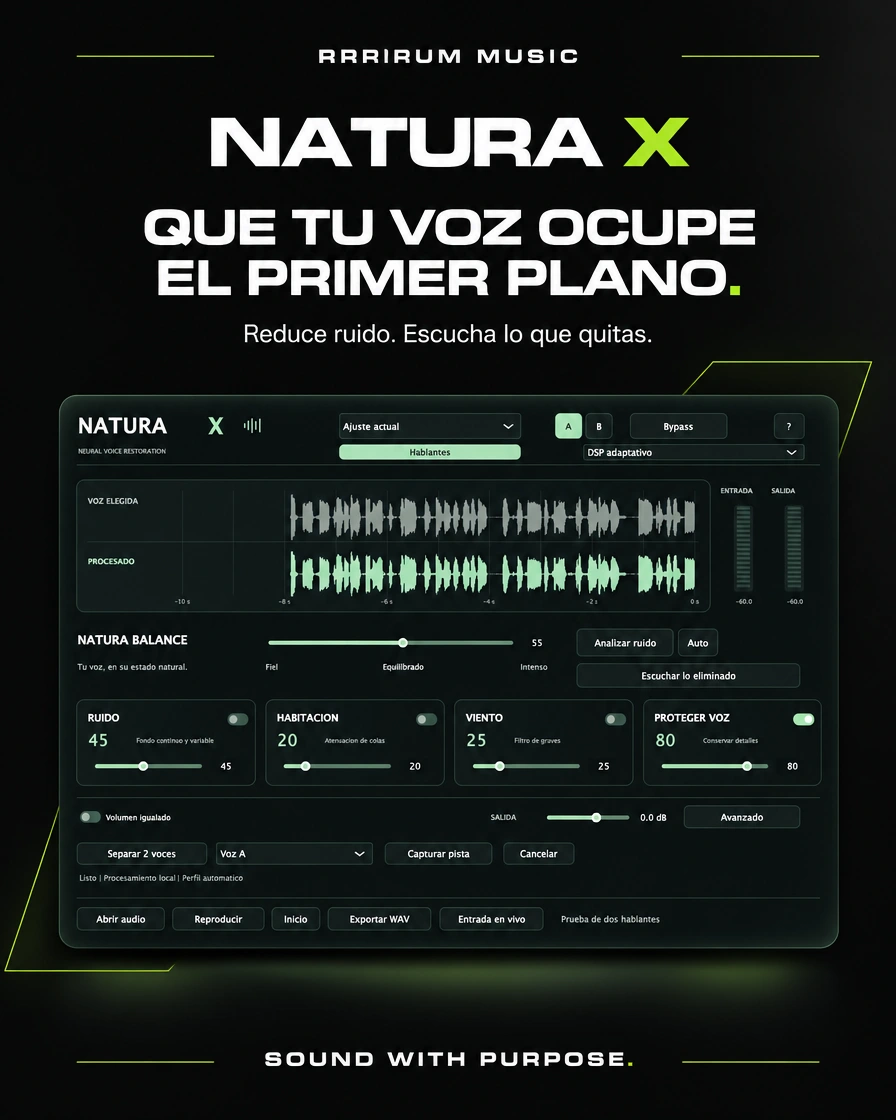
Interfaz nativa funcional de esta versión. Los datos visibles son ejemplos de prueba; los PNG completos están en Pantallas.
Qué incluye
• Limpieza DSP, neuronal e híbrida con controles de ruido, habitación y viento.
• Separación previa de dos voces y selección A/B para exportar la elegida.
• Escucha del residuo, protección de voz y comparación de ajustes.
Archivos de apoyo: el catálogo local incluye las capturas nativas completas, los logos y los manuales técnicos originales. Las vistas
vacías muestran controles reales; los ejemplos con audio proceden de pruebas. Consulta también la validación de esta versión.
Página 2
Flujo rápido
1. Carga una toma o reproduce la entrada de tu DAW.
2. Elige DSP, Neuronal RNNoise o Híbrido y ajusta Balance/Ruido.
3. Comprueba Bypass y Escuchar lo eliminado para proteger palabras y aire.
4. Para elegir hablante, abre Hablantes, separa y escucha A/B.
5. Exporta la voz elegida y procesada; guarda el WAV con tu sesión.
Guardar tu trabajo
Parámetros y perfil en DAW; conserva/exporta los audios por separado.
Antes de empezar
La separación de hablantes es offline, mono, hasta 60 s y con banda hasta 8 kHz. La limpieza en vivo añade
latencia. No garantiza eliminar todo el eco ni recuperar voz destruida.
Compatibilidad común
Mac Apple Silicon, macOS 13.3 o posterior. Audio Unit, VST3 y aplicación independiente. Los instaladores no
tienen firma Developer ID ni notarización Apple; los binarios llevan firma local ad hoc. Procesamiento local.
Referencia completa de uso y controles
INSTALACION
1. Cierra Logic, Studio One y otras aplicaciones de audio.
2. Abre NATURA-X-1.2.0-macOS-AppleSilicon.pkg y sigue el instalador.
3. Abre NATURA X en Aplicaciones o busca NATURA Audio > NATURA X en tu DAW. Logic utiliza Audio Unit;
Studio One puede utilizar VST3 o Audio Unit.
4. Si tu DAW no lo encuentra, vuelve a explorar los plugins o reinicia la DAW. La instalacion solicita la
autorizacion normal de macOS para esas carpetas.
Este paquete tiene binarios con firma ad hoc local; el instalador no tiene firma Developer ID ni notarizacion de
Apple. Si macOS lo bloquea, comprueba su origen y utiliza la opcion Abrir igualmente de Privacidad y
seguridad si deseas abrirlo. No desactives la seguridad del sistema. No es una version para Windows ni Intel.
NOVEDAD 1.2 - ELEGIR QUE HABLANTE CONSERVAR
Pulsa Hablantes. Esta funcion realiza un calculo PREVIO sobre una grabacion con hasta dos hablantes; no es
seleccion de hablante en directo.
1. Abre o arrastra un archivo de 0.5 a 60 segundos. Tambien puedes Capturar pista: inicia la reproduccion en
tu DAW, captura la entrada, deten la captura.
Página 3
2. Pulsa Separar 2 voces y espera. Cancelar detiene el calculo si lo necesitas.
3. Elige Voz A, pulsa Reproducir y escucha; luego prueba Voz B.
4. Conserva la voz deseada con ese selector y pulsa Exportar WAV.
5. En una DAW, importa el WAV exportado en la posicion del audio original. La preescucha del plugin
reemplaza temporalmente la entrada mientras se reproduce el archivo; no esta sincronizada al transporte de la
DAW. Al detener la preescucha, el plugin vuelve a procesar la entrada de la pista. El selector Mezcla original
vuelve a la grabacion completa. Despues de elegir una voz, puedes usar RNNoise/DSP para limpiar el
resultado. La grafica superior muestra VOZ ELEGIDA; Bypass compara esa voz antes y despues de la
limpieza. Para comparar contra todas las voces usa Mezcla original en el selector. Al exportar se usa la voz
elegida, no siempre la mezcla.
Alcance: DOS salidas mono. El audio estereo se mezcla a mono para separar.
El modelo funciona a 16 kHz: las voces separadas tienen banda hasta 8 kHz, aunque el WAV conserve la
frecuencia original del archivo. Las etiquetas A/B son arbitrarias y pueden cambiar al analizar otra grabacion.
No es un sistema de reconocimiento de identidad ni de seleccion por muestra de referencia. No hay garantias
para tres voces, canto, voces muy similares o ruido extremo. La separacion consume memoria y puede tardar.
El progreso muestra etapas. No cierres la DAW durante el calculo; utiliza Cancelar primero. Se conserva la
seleccion como parametro de sesion, pero los archivos y las voces separadas NO se incrustan en la sesion.
Exporta los resultados para guardarlos e importalos en tu proyecto; al reabrir hace falta cargar/separar otra
vez si deseas usar la preescucha del plugin. Esta version requiere macOS 13.3+ por el runtime de separacion
incorporado. La latencia de limpieza sigue siendo la misma que en 1.1; la separacion es un proceso previo y
no se presenta como parte de esa latencia en directo.
NOVEDAD 1.1 - MOTOR NEURONAL LOCAL
RNNoise 0.2 y su modelo oficial 0b50c45 estan integrados en los binarios. No hace falta descargar modelos,
introducir claves ni conectarse a internet. En la cabecera elige DSP adaptativo, Neuronal RNNoise o Hibrido
neuronal. Las instancias nuevas empiezan en Hibrido; las sesiones 1.0 conservan DSP. Para activar la mejora
en una sesion anterior, cambia el selector a Hibrido. Ruido, NATURA Balance y Proteger voz coordinan la
mezcla neuronal. Avanzado incluye Intensidad neuronal (0-100). Ruido en 0 desactiva la mezcla neuronal. En
modo Neuronal no hace falta un perfil: Analizar ruido, Auto y congelacion de perfil quedan desactivados. El
modo Neuronal conserva los filtros opcionales de graves/colas/zumbido, pero omite la supresion espectral de
ruido. Hibrido combina la red y DSP moderado. El modelo esta entrenado para voz hablada: los presets Canto
y Maxima fidelidad eligen DSP para evitar supresion de contenido musical. Revisa siempre el residuo.
RNNoise por si solo no identifica ni separa hablantes. Utiliza el panel Hablantes para la separacion previa de
DOS voces. No hay reconstruccion generativa. El modelo corre internamente a 48 kHz con remuestreo sinc de
64 coeficientes.
Pruebas de alineacion: 16, 32, 44.1, 48, 88.2, 96 y 192 kHz, mono/estereo. La red utiliza estados
independientes por canal; una imagen estereo compleja puede variar. Los canales identicos se conservan
identicos. Cambiar de motor no cambia la latencia. El modelo permanece preparado para permitir transiciones
suaves; DSP no representa un modo de ahorro de CPU. Despues de cambiar de motor, usa Auto o captura un
perfil nuevo de ruido.
Página 4
PRIMER USO EN UNA PISTA
Inserta NATURA X como efecto. Empieza con Equilibrado o Podcast cercano. Reproduce un fragmento
representativo y ajusta NATURA Balance y Ruido. Para un perfil fijo, pulsa Analizar ruido durante dos
segundos de SOLO RUIDO. No hables durante la captura. Necesita la reproduccion activa de la DAW/app.
Auto elimina ese perfil y vuelve a estimar el fondo continuamente. Comprueba Bypass y Escuchar lo
eliminado. Si hay palabras en el residuo, reduce intensidad o aumenta Proteger voz. La compensacion de
volumen no convierte la comparacion en una medicion de calidad. Puede elevar el fondo.
APLICACION INDEPENDIENTE
Abre/arrastra WAV, AIFF, FLAC u otro formato que pueda leer el sistema.
Limite: 10 minutos, mono o estereo. Reproduce, compara y exporta WAV 24-bit. Se conserva la duracion,
frecuencia de muestreo y canales del archivo fuente. Exportar guarda el resultado procesado,
independientemente de Bypass y Residuo. Si el perfil se capturo a otra frecuencia que el archivo, la
exportacion usa estimacion automatica; el remuestreo de escucha puede diferir del render. Si hay picos
superiores a 0 dBFS, baja Salida. El exportador avisa si recorto picos. Los archivos largos consumen
memoria: esta version carga el archivo completo. Para microfono selecciona Entrada en vivo y el dispositivo
en Options > Audio/MIDI Settings. Autoriza el microfono si macOS lo solicita. El anfitrion independiente puede
mantener la entrada silenciada: revisa su aviso de mute. Usa auriculares para evitar realimentacion. No se
instala un microfono virtual.
CONTROLES
NATURA Balance: intensidad coordinada de ruido, graves y colas.
Ruido: intensidad de la separacion neuronal y/o supresion espectral segun motor.
Habitacion: atenuacion conservadora de colas espectrales. NO elimina todo el eco.
Viento: filtro de graves variable; no reconstruye golpes de viento saturados.
Proteger voz: limita la atenuacion; no reconoce personas ni palabras.
Avanzado: intensidad neuronal, zumbidos 50/60 Hz y congelacion de perfil automatico.
A/B: dos memorias de parametros durante la apertura del editor.
Salida: ganancia de -18 a +12 dB. Bypass mantiene latencia; Salida sigue activa.
Volumen igualado: compensacion RMS lenta entre -3.1 y +6 dB aproximadamente.
Residuo: original alineado menos procesado, antes de compensar volumen y Salida.
Doble clic en un deslizador: valor inicial. Valores 0-100 son ajustes, no porcentajes de ruido eliminado.
Medidor de reduccion: promedio de ganancias espectrales, no porcentaje de limpieza ni puntuacion de
naturalidad.
SESIONES Y RENDIMIENTO
Automatizacion de parametros y recuperacion del perfil capturado con la sesion. El perfil se conserva para la
frecuencia de muestreo a la que se capturo.
Página 5
Cambio de frecuencia: captura un nuevo perfil. Los archivos abiertos y las memorias A/B no se incluyen en el
estado de la sesion.
Latencia fija entre motores: 1024 + ceil(0.04 * frecuencia) muestras.
A 48 kHz: 2944 muestras / 61.33 ms. A 44.1 kHz: 2788 / 63.22 ms.
A 96 kHz: 4864 / 50.67 ms. El plugin informa la latencia al anfitrion. Esta latencia puede resultar perceptible al
monitorizar la voz en directo. Mono y estereo; DSP enlazado y red neuronal independiente por canal.
Procesamiento local, sin conexion ni telemetria. Contiene RNNoise y Conv-TasNet para separacion previa de
dos voces. No recupera fielmente voz destruida por saturacion o ruido extremo; pueden quedar fugas entre
voces.
ARCHIVOS INSTALADOS
/Applications/NATURA X.app /Library/Audio/Plug-Ins/Components/NATURA X.component
/Library/Audio/Plug-Ins/VST3/NATURA X.vst3 /Library/Documentation/NATURA X/ Para desinstalar, cierra las
apps y mueve esos elementos a la papelera.
FUENTE Y LICENCIAS
Se entrega el codigo correspondiente completo bajo AGPL-3.0-only, junto con JUCE 8.0.12, RNNoise 0.2, los
pesos del modelo y sus avisos. Consulta COPYING.txt, JUCE-LICENSE.md, RNNOISE-LICENSE.txt y
MODEL-INFO.txt; ademas SPEAKER-MODEL-INFO.txt y las licencias ONNX/CC-BY-SA. El archivo
Source.zip instalado contiene las instrucciones para compilar. Entrega funcional con limites documentados; no
es una certificacion comercial.
 ALPHA CENTAURIP L U G I N S